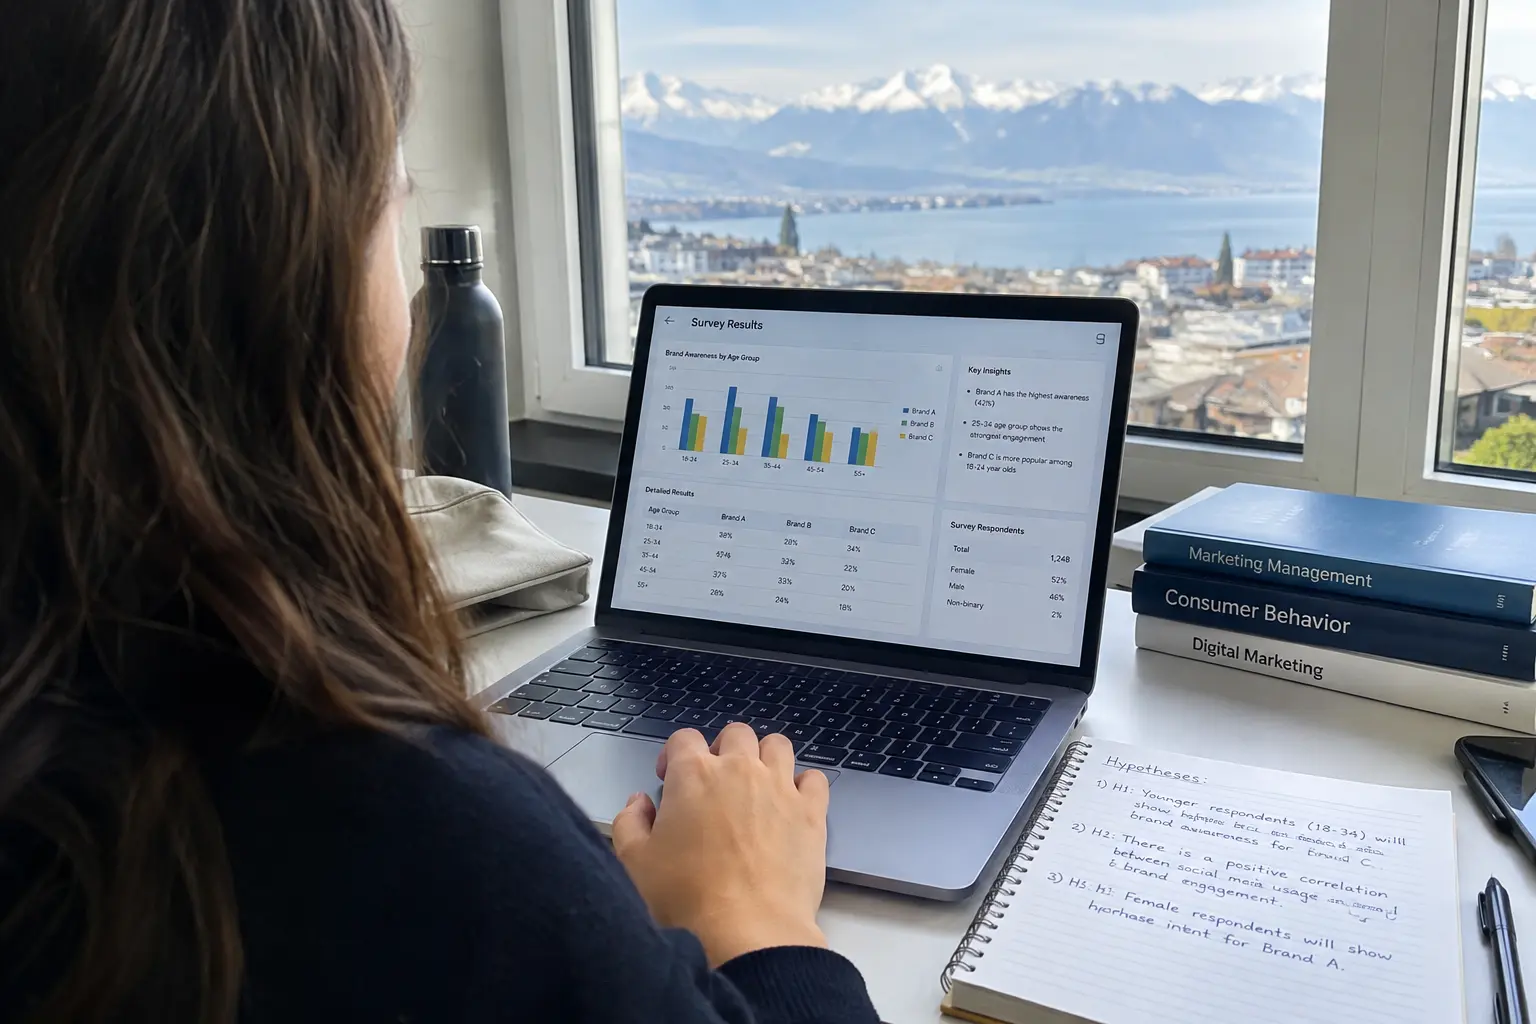
Der Ergebnisteil einer quantitativen Marketing-Bachelorarbeit mit Umfragedaten ist oft der Abschnitt, in dem eine methodisch solide Erhebung an einer unübersichtlichen Präsentation scheitert: zu viele Tabellen, keine klare Verbindung zu den Hypothesen, oder Interpretation, die sich unbemerkt in die Ergebnisdarstellung einschleicht. Dieser Beitrag zeigt, wie du deskriptive Statistik, Tabellen und Abbildungen sauber strukturierst, jede Hypothese systematisch beantwortest und den Ergebnisteil so aufbaust, dass er im Kolloquium überzeugt – inklusive eines durchgerechneten Beispiels, einer Checkliste für den letzten Blick vor der Abgabe und Antworten auf typische Fragen zum Ergebnisteil, von der Reihenfolge der Hypothesen bis zum Umgang mit Mediationseffekten, kleinen Stichproben und der richtigen Zahl an Nachkommastellen.
Der rote Faden: Ergebnisse folgen den Hypothesen, nicht dem Fragebogen
Ein häufiger struktureller Fehler ist, den Ergebnisteil entlang der Fragebogenreihenfolge aufzubauen – Frage 1, Frage 2, Frage 3 – statt entlang der Forschungsfragen oder Hypothesen. Diese Fragebogenlogik ist für die Datenerhebung sinnvoll, aber für die Ergebnisdarstellung meist unübersichtlich, weil einzelne Hypothesen oft mehrere Items gleichzeitig betreffen. Besser ist eine Gliederung, die mit der deskriptiven Statistik zur Stichprobe beginnt, dann die deskriptive Statistik zu den zentralen Konstrukten liefert, und erst danach Hypothese für Hypothese die zugehörigen Inferenzstatistiken berichtet. Diese Struktur führt Leser:innen vom Allgemeinen (wer wurde befragt) über das Beschreibende (wie sehen die Daten grob aus) zum Spezifischen (was sagen die Daten zu jeder einzelnen Hypothese), und sie entspricht der Erwartung, mit der Gutachtende an eine Marketing-Bachelorarbeit herangehen.
Deskriptive Statistik zur Stichprobe zuerst
Vor den eigentlichen Hypothesentests gehört eine kurze deskriptive Übersicht der Stichprobe: Anzahl der auswertbaren Fragebögen, Rücklaufquote, demografische Zusammensetzung (Alter, Geschlecht, allenfalls Branche oder Kaufhäufigkeit, je nach Fragestellung). Diese Übersicht lässt sich kompakt in einer Tabelle mit Häufigkeiten und Prozentanteilen darstellen und gibt Leser:innen eine Einschätzung, wie repräsentativ oder zumindest wie beschaffen die Stichprobe ist, bevor die inhaltlichen Ergebnisse folgen. Bei einer Convenience-Stichprobe über soziale Medien lohnt sich zusätzlich ein kurzer Hinweis auf mögliche Verzerrungen in der demografischen Zusammensetzung, ohne dass dies bereits als Limitation ausführlich diskutiert wird – das gehört in die Diskussion.
Deskriptive Statistik zu den zentralen Konstrukten
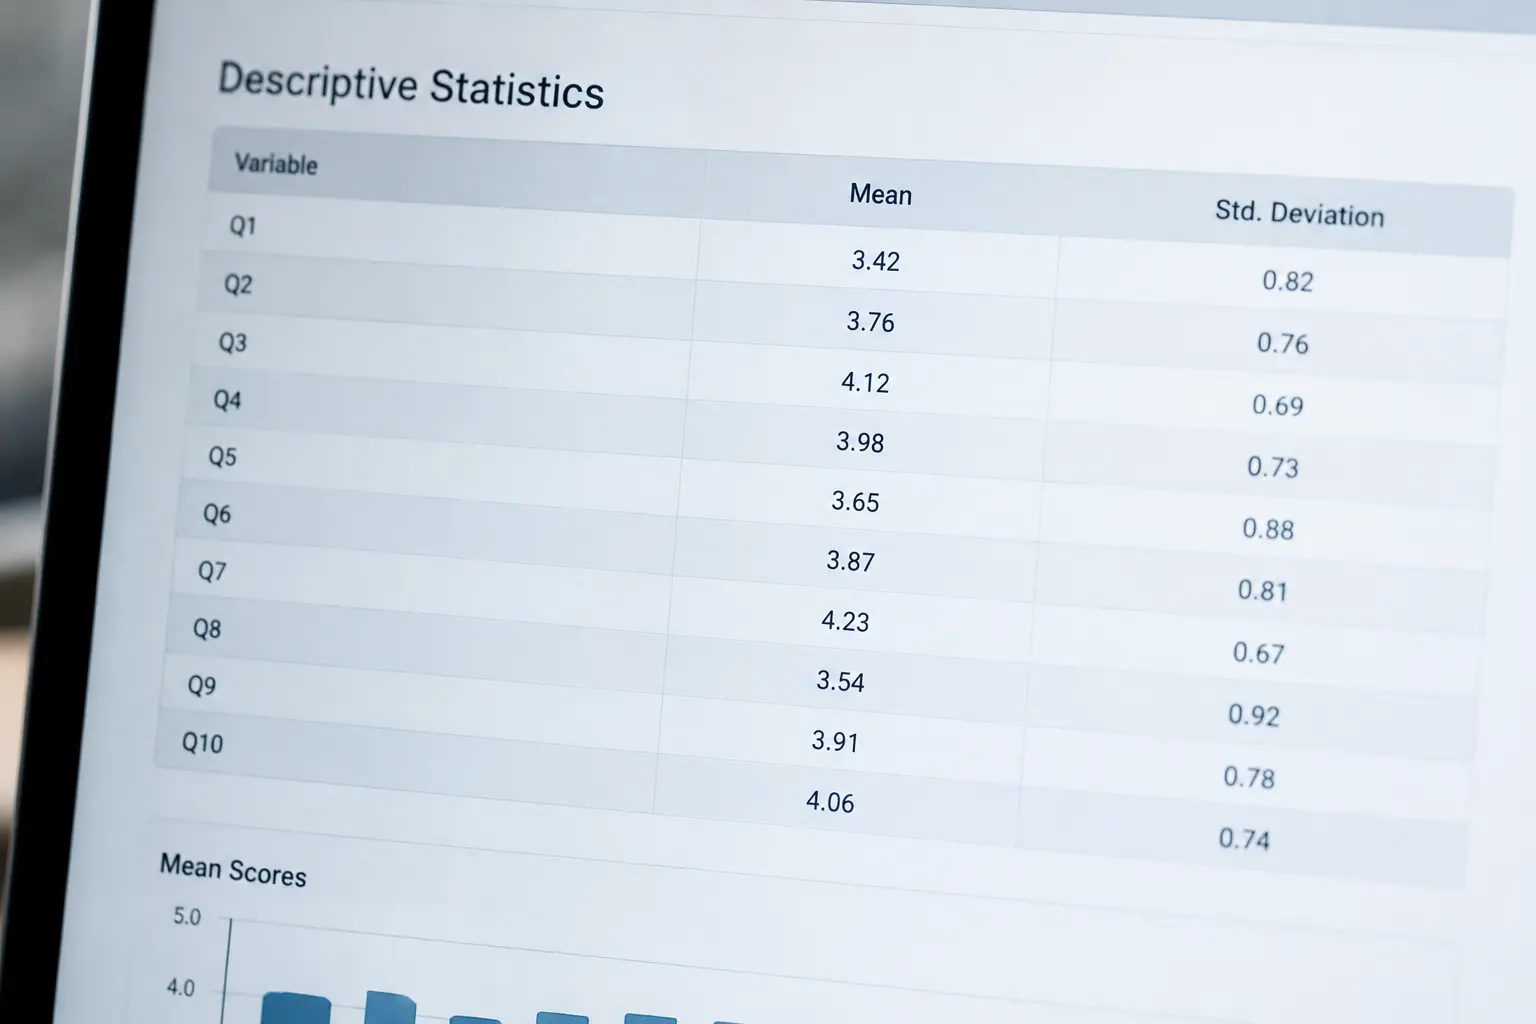
Nach der Stichprobenbeschreibung folgt eine deskriptive Tabelle zu den zentralen Konstrukten der Arbeit: Mittelwert, Standardabweichung, Minimum und Maximum je Skala oder Item, idealerweise ergänzt um die Reliabilität (Cronbachs Alpha) der jeweiligen Skala, sofern diese nicht bereits vollständig im Methodenkapitel steht. Diese Tabelle beantwortet noch keine Hypothese, gibt aber einen ersten Eindruck der Datenlage – etwa ob eine Variable eine auffällige Deckeneffekt-Tendenz zeigt (fast alle Werte am oberen Ende der Skala), was spätere Signifikanztests einschränken kann.
Tabellen und Abbildungen: wann welches Format
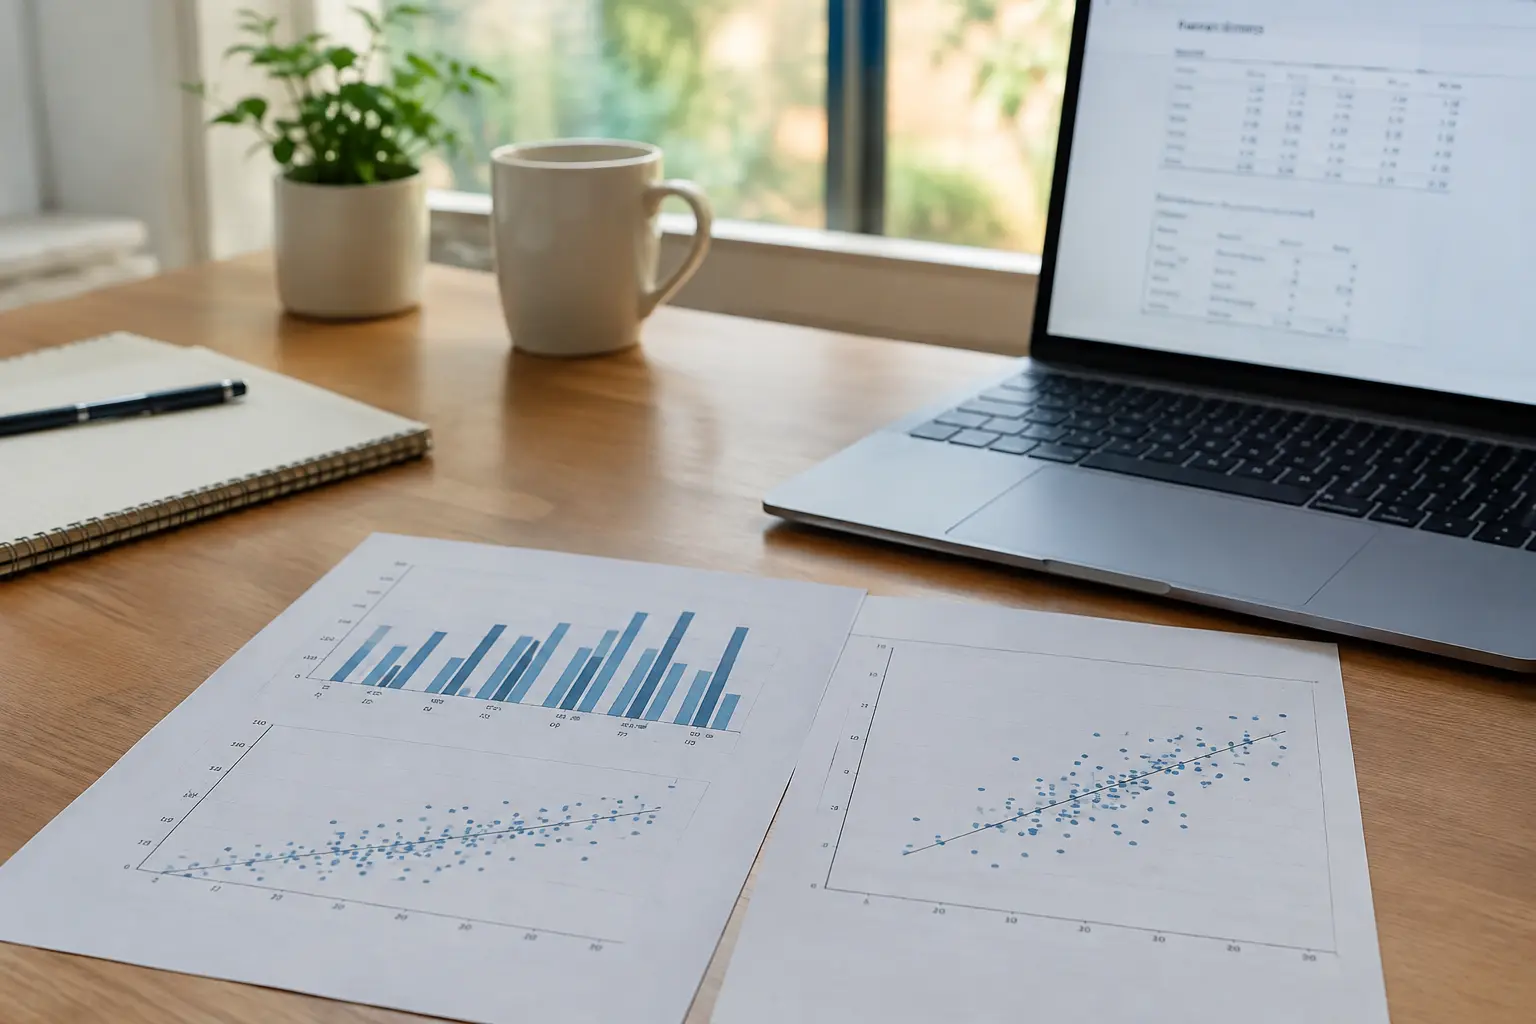
Tabellen eignen sich für präzise Zahlenwerte, die Leser:innen nachschlagen wollen (Mittelwerte, p-Werte, Konfidenzintervalle); Abbildungen eignen sich, um Muster, Trends oder Vergleiche auf einen Blick sichtbar zu machen (Gruppenunterschiede als Balkendiagramm, Zusammenhänge als Streudiagramm). Eine verbreitete Fehlentscheidung ist, dieselbe Information doppelt als Tabelle und Abbildung zu präsentieren – das verdoppelt den Platzbedarf ohne Erkenntnisgewinn. Als Faustregel: Wenn die genaue Zahl wichtig ist, eine Tabelle; wenn die Form des Musters wichtig ist, eine Abbildung. Jede Tabelle und jede Abbildung braucht zudem eine eigenständige, verständliche Beschriftung, die auch ohne Fliesstext nachvollziehbar ist.
Jede Hypothese einzeln und vollständig berichten
Für jede Hypothese sollte der Ergebnisteil in derselben Reihenfolge berichten: die verwendete Prüfgrösse (t-Test, ANOVA, Korrelation, Regression), die deskriptiven Kennwerte der beteiligten Gruppen oder Variablen, der Testwert mit Freiheitsgraden, der p-Wert, die Effektstärke und schliesslich ein Satz, ob die Hypothese angenommen oder verworfen wird. Diese Reihenfolge sollte für alle Hypothesen konsistent eingehalten werden – ein wechselnder Detailgrad zwischen den Hypothesen wirkt unsystematisch und erschwert Leser:innen den Vergleich. Wurden Voraussetzungsprüfungen (Normalverteilung, Varianzhomogenität) durchgeführt, gehört ein kurzer Hinweis dazu vor den eigentlichen Testergebnissen, nicht erst im Anhang versteckt.
Effektstärken nicht vergessen
Ein p-Wert allein sagt nichts über die praktische Bedeutsamkeit eines Effekts aus – bei einer grossen Stichprobe wird selbst ein winziger, praktisch irrelevanter Unterschied signifikant. Deshalb gehört zu jedem berichteten Test eine Effektstärke (Cohens d bei Gruppenvergleichen, r oder R² bei Zusammenhängen und Regressionen). Im Marketing-Kontext lässt sich eine kleine, aber signifikante Effektstärke oft zusätzlich einordnen, indem man sie mit der Grössenordnung vergleichbarer publizierter Studien in Bezug setzt, sofern solche Referenzwerte im Theorieteil bereits eingeführt wurden.
Regressionsergebnisse übersichtlich darstellen
Bei einer multiplen Regression, wie sie in Marketing-Bachelorarbeiten häufig zur Prüfung mehrerer Prädiktoren einer abhängigen Variable (etwa Kaufabsicht) eingesetzt wird, gehört eine Standardtabelle mit unstandardisierten und standardisierten Koeffizienten (B und Beta), Standardfehler, t-Wert, p-Wert je Prädiktor sowie dem Gesamtmodell-R² und der F-Statistik in den Ergebnisteil. Diese Tabelle ist Standard in der Marketingforschung und erlaubt Leser:innen, die relative Bedeutung der Prädiktoren direkt an den standardisierten Koeffizienten abzulesen, ohne den Fliesstext lesen zu müssen. Bei mehreren aufeinander aufbauenden Modellen (hierarchische Regression) sollte zusätzlich die Veränderung von R² zwischen den Modellschritten ausgewiesen werden.
Moderations- und Mediationsanalysen im Marketing
Viele Marketing-Bachelorarbeiten prüfen nicht nur direkte Zusammenhänge, sondern auch Moderations- oder Mediationseffekte – etwa ob der Effekt von Werbebotschaften auf die Kaufabsicht je nach Markenvertrautheit unterschiedlich stark ausfällt (Moderation), oder ob dieser Effekt über die wahrgenommene Glaubwürdigkeit vermittelt wird (Mediation). Für solche Analysen gehört neben den Koeffiziententabellen auch eine grafische Darstellung der Interaktion (bei Moderation) oder ein Pfaddiagramm mit den indirekten und direkten Effekten (bei Mediation) in den Ergebnisteil. Für indirekte Effekte sollten Bootstrapping-Konfidenzintervalle explizit berichtet werden; in der aktuellen Methodenliteratur werden sie gegenüber älteren Einzeltests wie dem Sobel-Test in der Regel bevorzugt, weil indirekte Effekte oft nicht normalverteilt sind.
Darstellung und Interpretation sauber trennen
Auch in quantitativen Arbeiten gilt: Der Ergebnisteil berichtet, was die Statistik zeigt, nicht, was das für die Marketingpraxis bedeutet. Ein Satz wie «Die Werbewirkung ist bei jüngeren Konsument:innen signifikant stärker (p < .01), was bedeutet, dass Unternehmen ihr Marketingbudget auf jüngere Zielgruppen verlagern sollten» vermischt ein statistisches Ergebnis mit einer strategischen Handlungsempfehlung, die in die Diskussion gehört. Im Ergebnisteil endet der Satz nach dem statistischen Befund; die Handlungsempfehlung folgt separat und explizit als Interpretation. Diese Trennung schützt zudem davor, aus einer einzelnen Stichprobe voreilige Verallgemeinerungen für den gesamten Markt abzuleiten.
Umgang mit unerwarteten oder widersprüchlichen Ergebnissen
Nicht jede Hypothese bestätigt sich, und gelegentlich zeigt sich sogar ein Effekt in die entgegengesetzte Richtung der Erwartung. Solche Ergebnisse gehören genauso nüchtern und vollständig berichtet wie bestätigende Befunde – ein Ergebnisteil, der nur die «passenden» Befunde ausführlich darstellt und unerwünschte Resultate knapp abhandelt, wirkt selektiv und schwächt die Glaubwürdigkeit der gesamten Auswertung. Die Erklärung für ein unerwartetes Ergebnis gehört in die Diskussion, nicht in den Ergebnisteil selbst.
Ein durchgerechnetes Beispiel (fiktiv)
Angenommen, eine Bachelorarbeit untersucht mittels Online-Umfrage (n = 184) den Einfluss von Influencer-Glaubwürdigkeit auf die Kaufabsicht bei Schweizer Konsument:innen zwischen 18 und 35 Jahren. Der Ergebnisteil beginnt mit der Stichprobenbeschreibung (Alter, Geschlecht, Social-Media-Nutzungsintensität), gefolgt von der deskriptiven Statistik zu den drei zentralen Skalen (Glaubwürdigkeit, Produktinvolvement, Kaufabsicht) inklusive Cronbachs Alpha. Für Hypothese 1 («Wahrgenommene Glaubwürdigkeit hängt positiv mit der Kaufabsicht zusammen») wird eine Korrelation berichtet (r = .42, p < .001), für Hypothese 2 («Produktinvolvement moderiert diesen Zusammenhang») eine moderierte Regression mit Interaktionsterm. Beide Ergebnisse werden mit Tabelle und, für die Interaktion, zusätzlich mit einem einfachen Interaktionsdiagramm dargestellt. Die Einordnung, was diese Ergebnisse für Influencer-Marketing-Strategien in der Schweiz bedeuten, folgt separat in der Diskussion. Dieses Beispiel ist illustrativ; die konkreten Verfahren hängen vom eigenen Design und Skalenniveau ab.
Checkliste für den Ergebnisteil
| Element | Worauf achten |
|---|---|
| Stichprobenbeschreibung | Anzahl, Rücklauf, Demografie vor den Hypothesentests |
| Deskriptive Statistik | Mittelwert, Standardabweichung, Reliabilität je Konstrukt |
| Konsistente Berichtsstruktur | Gleicher Detailgrad und gleiche Reihenfolge für jede Hypothese |
| Effektstärken | Immer zusätzlich zum p-Wert angeben |
| Trennung von Interpretation | Statistischer Befund im Ergebnisteil, Bedeutung in der Diskussion |
| Tabellen vs. Abbildungen | Nicht dieselbe Information doppelt darstellen |
| Unerwartete Ergebnisse | Genauso vollständig berichten wie bestätigende Befunde |
FAQ
In welcher Reihenfolge sollten Hypothesen im Ergebnisteil berichtet werden?
In derselben Reihenfolge, in der sie im Theorie- oder Methodenkapitel eingeführt wurden, nicht in der Reihenfolge der Fragebogenitems. Eine konsistente Nummerierung (H1, H2, H3) erleichtert Leser:innen die Orientierung.
Muss ich bei jedem Test eine Effektstärke angeben?
Ja, eine Effektstärke gehört zu jedem berichteten Signifikanztest, weil der p-Wert allein nichts über die praktische Bedeutsamkeit des Effekts aussagt.
Wie stelle ich eine nicht signifikante Hypothese dar?
Genauso systematisch wie eine signifikante: Testverfahren, Kennwerte, p-Wert und die explizite Feststellung, dass die Hypothese nicht bestätigt werden konnte. Ein nicht signifikantes Ergebnis ist kein Fehler, sondern ein valider Befund.
Gehören Diagramme aus SPSS oder R direkt in die Arbeit?
Rohausgaben sollten für die Publikation überarbeitet werden: einheitliche Beschriftung, das in deinem Fach und Institut vorgegebene Dezimaltrennzeichen, Legenden und Achsentitel in der Sprache der Arbeit, keine Standardfarbschemata der Software ohne Anpassung.
Wie gehe ich mit mehreren Regressionsmodellen um?
Mehrere Modelle (etwa ein Basis- und ein erweitertes Modell mit Interaktionsterm) lassen sich in einer gemeinsamen Tabelle mit mehreren Spalten übersichtlich nebeneinanderstellen, inklusive der Veränderung von R² zwischen den Modellen.
Sollte ich alle erhobenen Variablen im Ergebnisteil berichten, auch wenn sie für keine Hypothese zentral sind?
Nein, nur die für die Forschungsfragen und Hypothesen relevanten Variablen gehören in den Ergebnisteil. Zusätzliche explorative Befunde können kurz und klar als solche gekennzeichnet ergänzt werden, sollten aber nicht den Kern verwässern.
Wie lang sollte der Ergebnisteil einer quantitativen Marketing-Bachelorarbeit sein?
Eine allgemeingültige Vorgabe gibt es nicht. Der Umfang hängt von der Anzahl der Hypothesen, der Zahl der Tabellen und Abbildungen und den Vorgaben deines Instituts ab; massgeblich sind das Merkblatt des Studiengangs und die Absprache mit der Betreuungsperson.
Was mache ich, wenn ein Ergebnis der Erwartung widerspricht?
Genauso nüchtern berichten wie ein bestätigendes Ergebnis, inklusive aller Kennwerte. Die Erklärung, warum das Ergebnis von der Erwartung abweicht, gehört in die Diskussion, nicht in den Ergebnisteil.
Wie berichte ich einen Mediationseffekt korrekt?
Mit dem indirekten Effekt, dessen Bootstrapping-Konfidenzintervall, sowie dem direkten und dem totalen Effekt, idealerweise ergänzt um ein Pfaddiagramm. Ältere Einzeltests wie der Sobel-Test werden dafür in der aktuellen Methodenliteratur meist nicht mehr als alleinige Grundlage empfohlen.
Wie viele Nachkommastellen sollten statistische Kennwerte in Tabellen haben?
Üblich sind zwei Nachkommastellen für Mittelwerte, Standardabweichungen und Korrelationen, sowie drei Nachkommastellen für p-Werte nahe der Signifikanzgrenze. Wichtig ist vor allem, die Genauigkeit über alle Tabellen der Arbeit hinweg konsistent zu halten.
Muss ich die Korrelationsmatrix aller Konstrukte vollständig abbilden?
Eine vollständige Korrelationsmatrix aller zentralen Konstrukte gehört häufig als eigene Tabelle in den Ergebnisteil, bevor die einzelnen Hypothesentests folgen, weil sie Leser:innen einen schnellen Überblick über alle bivariaten Zusammenhänge gibt, ohne dass jeder Zusammenhang im Fliesstext einzeln benannt werden muss.
Was tue ich, wenn die Stichprobengrösse für einen geplanten Test zu klein ausfällt?
Der Ergebnisteil sollte dies transparent benennen, etwa durch Angabe der tatsächlichen Zellenbesetzung bei einer Gruppenanalyse, statt den Test trotzdem unkommentiert durchzuführen. Die methodische Konsequenz daraus – etwa ein robusteres, verteilungsfreies Verfahren – gehört ins Methodenkapitel, der Hinweis auf die kleine Stichprobe kurz in den Ergebnisteil.
Ein überzeugender quantitativer Ergebnisteil lebt von Konsistenz: dieselbe Berichtsstruktur für jede Hypothese, eine klare Trennung von Befund und Bedeutung, und Tabellen sowie Abbildungen, die einander ergänzen statt sich zu wiederholen. Wer diese Struktur konsequent durchhält über alle Hypothesen der Arbeit hinweg, liefert einen Ergebnisteil, der auch bei kritischer Prüfung im Kolloquium standhält und den Gutachtenden schon beim ersten Durchlesen zeigt, dass die statistische Auswertung sorgfältig, systematisch und regelgeleitet erfolgt ist.
Zur qualitativen Ergebnisdarstellung im Vergleich siehe auch Ergebnisse einer qualitativen Bachelorarbeit darstellen. Wie du eine überzeugende Problemstellung formulierst, erklärt Problemstellung der Bachelorarbeit. Was in eine saubere Abgrenzung des Themas gehört, zeigt Abgrenzung der Bachelorarbeit. Wie du zwischen linearer und logistischer Regression entscheidest, zeigt Lineare oder logistische Regression.