Zwei Gruppen, eine abhängige Variable, eine Frage: Unterscheiden sie sich? Und sofort die zweite Frage, an der die Auswertung hängen bleibt — t-Test oder Mann-Whitney-U-Test? Die Entscheidung ist in vier Prüfschritten getroffen, und sie kostet weniger, als die meisten befürchten. Wichtiger als die Wahl selbst ist, dass du sie vor dem Blick auf das Ergebnis triffst und im Methodenteil begründest.
Die beiden Tests prüfen nicht dasselbe
Der wichtigste Punkt zuerst, weil er in fast jeder Arbeit falsch steht: Es handelt sich nicht um zwei Rechenwege zum selben Ergebnis, sondern um zwei verschiedene Hypothesen.
Der t-Test für unabhängige Stichproben vergleicht die Mittelwerte zweier Gruppen und fragt, ob die beobachtete Differenz mit der Annahme gleicher Populationsmittelwerte vereinbar ist. Er braucht dafür metrische Daten, ungefähr normalverteilte Werte in beiden Gruppen und — in der klassischen Variante — ähnliche Varianzen.
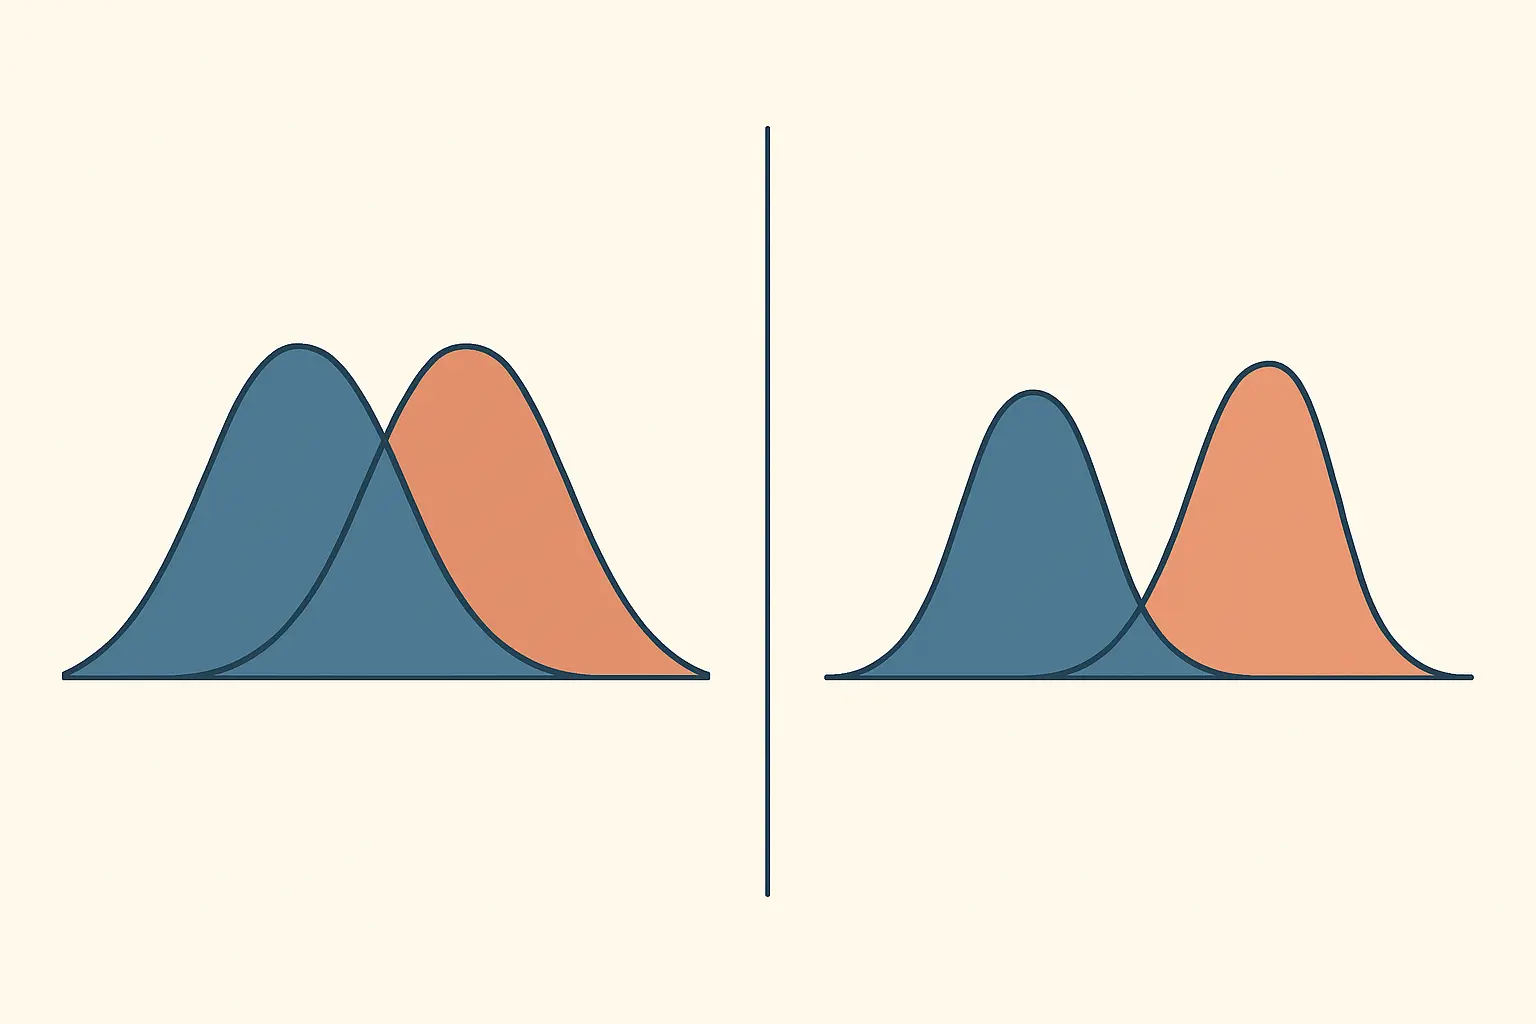
Der Mann-Whitney-U-Test ersetzt die Werte durch Ränge und prüft eine Aussage über stochastische Überlegenheit: Ist ein zufällig gezogener Wert aus Gruppe A mit höherer Wahrscheinlichkeit grösser als ein zufällig gezogener Wert aus Gruppe B? Nur wenn beide Verteilungen dieselbe Form und Streuung haben, lässt sich das als Aussage über die Mediane lesen. Diese Zusatzbedingung wird fast überall unterschlagen — und sie ist der Grund, warum «der Mann-Whitney-U-Test vergleicht die Mediane» nur unter Vorbehalt stimmt.
Praktische Konsequenz für deinen Text: Nach einem t-Test schreibst du über Mittelwerte, nach einem Mann-Whitney-U-Test über zentrale Tendenz, Rangverteilung oder — bei gleicher Verteilungsform — Mediane. Beide Male gibst du zusätzlich deskriptive Kennwerte an, damit die Leserschaft die Grössenordnung sieht.
Die Entscheidung in vier Fragen
- Welches Skalenniveau hat die abhängige Variable? Bei einem einzelnen Item einer Ratingskala, einer Rangfolge oder einer Schulnote ist die Antwort ordinal — dann fällt der t-Test weg. Bei einem gemittelten Skalenwert aus mehreren Items wird in der Praxis metrisch gerechnet, sofern die Skala genügend Abstufungen hat.
- Wie ist die Verteilung in jeder Gruppe? Prüfe getrennt je Gruppe mit einem Q-Q-Diagramm, nicht über die Gesamtstichprobe. Wie das geht und warum der Shapiro-Wilk-Test allein nicht reicht, steht im Beitrag zum Prüfen der Normalverteilung.
- Wie gross sind die Gruppen? Ab etwa 25 bis 30 Fällen je Gruppe und bei ähnlichen Gruppengrössen ist der t-Test gegenüber moderater Schiefe sehr robust. Unter 15 Fällen je Gruppe lässt sich die Verteilungsform kaum beurteilen — dort ist der Rangtest die vorsichtigere Wahl.
- Gibt es Ausreisser? Der Mittelwert reagiert stark auf einzelne Extremwerte, Ränge nicht. Ein einziger Wert kann ein t-Test-Ergebnis kippen; der Mann-Whitney-U-Test bleibt davon nahezu unberührt.
| Situation | Empfehlung | Begründung im Methodenteil |
|---|---|---|
| Metrisch, symmetrisch, n ≥ 30 je Gruppe, ähnliche Varianzen | t-Test | Voraussetzungen grafisch geprüft und erfüllt |
| Metrisch, symmetrisch, aber Levene-Test signifikant | Welch-Test | Varianzheterogenität, korrigierte Freiheitsgrade |
| Metrisch, deutlich schief, n < 25 je Gruppe | Mann-Whitney-U-Test | Normalverteilungsannahme verletzt, kleine Stichprobe |
| Ordinalskaliert (Einzelitem, Rangfolge) | Mann-Whitney-U-Test | Skalenniveau lässt keine Mittelwerte zu |
| Metrisch, aber einzelne extreme Ausreisser | Mann-Whitney-U-Test oder robustes Verfahren | Robustheit gegenüber Extremwerten |
| Sehr ungleiche Gruppen (z. B. 12 gegen 90) | Welch-Test, ergänzend Rangtest | Ungleiche n und Varianzen kombiniert |
Der dritte Kandidat: der Welch-Test
Die häufigste Fehlreaktion in Abschlussarbeiten: Der Levene-Test wird signifikant, und daraufhin wird auf den Mann-Whitney-U-Test gewechselt. Das ist eine Antwort auf die falsche Frage. Ungleiche Varianzen sind kein Verteilungsproblem — sie sind ein Streuungsproblem, und die passende Korrektur ist der Welch-Test.
Der Welch-Test ist eine Variante des t-Tests, die die Freiheitsgrade nach unten korrigiert und deshalb gebrochene df ausgibt (etwa df = 41,73). Er setzt weiterhin annähernd symmetrische Verteilungen voraus, aber keine gleichen Varianzen. In vielen Statistikprogrammen ist er inzwischen die Voreinstellung — mit gutem Grund: Bei tatsächlich gleichen Varianzen verliert er praktisch nichts, bei ungleichen schützt er zuverlässig.
Merke also: schiefe Verteilung → Rangtest; ungleiche Varianz → Welch; beides zusammen → Rangtest, und zwar mit dem Hinweis, dass dann auch der Mann-Whitney-U-Test nur eingeschränkt als Medianvergleich lesbar ist.
Was der Wechsel an Teststärke kostet
Die Sorge, mit einem nichtparametrischen Test «schlechtere» Ergebnisse zu bekommen, ist meist unbegründet. Sind die Daten tatsächlich normalverteilt, liegt der Effizienzverlust des Mann-Whitney-U-Tests gegenüber dem t-Test bei rund fünf Prozent — die Rangversion braucht also grob fünf Prozent mehr Fälle für dieselbe Teststärke.
Bei schiefen Verteilungen oder schweren Verteilungsenden kehrt sich das Verhältnis sogar um: Dort ist der Rangtest stärker als der t-Test, weil Extremwerte die Streuungsschätzung nicht mehr aufblähen. Der Rangtest ist also kein Notbehelf, sondern in bestimmten Situationen das bessere Instrument.
Für die Planung heisst das: Rechne die Fallzahl für das parametrische Verfahren und schlage etwa 15 Prozent auf, wenn ein Rangtest wahrscheinlich ist. Die Rechnung dazu steht im Beitrag zur Stichprobengrösse mit G*Power.
Effektstärken für beide Verfahren
Ein p-Wert allein ist heute in keiner Fachrichtung mehr ausreichend. Beide Tests haben eigene Effektstärkemasse:
- Zum t-Test: Cohens d, berechnet als Mittelwertdifferenz geteilt durch die gepoolte Standardabweichung. Bei kleinen Stichproben ist Hedges‘ g die weniger verzerrte Variante. Orientierung nach Cohen: 0,20 klein, 0,50 mittel, 0,80 gross.
- Zum Mann-Whitney-U-Test: die rangbiseriale Korrelation oder das aus der Standardnormalverteilung abgeleitete r = |Z| / √N mit denselben Richtwerten wie eine Korrelation (0,10 / 0,30 / 0,50). Beide beziehen sich auf Ränge, nicht auf Mittelwerte, und sind entsprechend zu interpretieren.
Gib in jedem Fall zusätzlich die deskriptiven Kennwerte an: beim t-Test Mittelwert und Standardabweichung je Gruppe, beim Rangtest Median und Interquartilsabstand sowie die mittleren Ränge. Erst diese Zahlen machen dein Ergebnis für Leserinnen und Leser einschätzbar.
Der Weg im Programm
In SPSS liegen die beiden Verfahren in unterschiedlichen Menüzweigen, was den Wechsel unnötig umständlich wirken lässt. Der t-Test steht unter Analysieren → Mittelwerte vergleichen → T-Test bei unabhängigen Stichproben; die Gruppenvariable muss dort über «Gruppen definieren» mit ihren beiden Codes eingetragen werden, sonst bleibt die Schaltfläche inaktiv. Die Ausgabe enthält immer beide Zeilen — «Varianzen sind gleich» und «Varianzen sind nicht gleich» —, und die zweite ist der Welch-Test. Welche der beiden Zeilen du berichtest, entscheidet der Levene-Test in derselben Tabelle.
Der Mann-Whitney-U-Test findet sich unter Analysieren → Nichtparametrische Tests → Alte Dialogfelder → Zwei unabhängige Stichproben. Die klassische Ausgabe liefert U, Wilcoxons W, den Z-Wert und die asymptotische Signifikanz; bei kleinen Stichproben unter etwa zwanzig Fällen je Gruppe solltest du zusätzlich die exakte Signifikanz anfordern, weil die asymptotische Näherung dort ungenau wird. Die mittleren Ränge stehen in der Tabelle darüber und gehören mit in den Bericht.
In jamovi und JASP liegen beide Tests im selben Dialog: Du kreuzt unter «Tests» einfach zusätzlich «Mann-Whitney U» an und bekommst beide Ergebnisse nebeneinander — samt Effektstärke und Voraussetzungsprüfung als Optionen. Das erleichtert die geplante Robustheitsprüfung erheblich. Für die anschliessende Auswertung mehrerer Prädiktoren führt der Weg dann weiter zur multiplen Regression in SPSS.
So berichtest du das Ergebnis
t-Test: «Die Interventionsgruppe (M = 4,21, SD = 0,68) erzielte signifikant höhere Werte als die Kontrollgruppe (M = 3,74, SD = 0,71), t(96) = 3,34, p = ,001, d = 0,68.»
Welch-Test: «… t(78,42) = 3,11, p = ,003, d = 0,64. Aufgrund eines signifikanten Levene-Tests wurde die Welch-Korrektur verwendet.»
Mann-Whitney-U-Test: «Die Interventionsgruppe (Mdn = 4,00, IQR = 1,00) unterschied sich signifikant von der Kontrollgruppe (Mdn = 3,50, IQR = 1,25), U = 728,50, Z = −2,87, p = ,004, r = ,29.»
Beachte im deutschsprachigen Text das Dezimalkomma und die weggelassene führende Null bei Kennwerten, die nicht über eins hinausgehen können. Wie du Teststatistiken insgesamt formatierst, behandelt der Beitrag zum quantitativen Forschungsdesign im Abschnitt zur Ergebnisdarstellung.
Die Entscheidung begründen, nicht nur treffen. Gutachtende bewerten den Absatz, in dem du erklärst, warum dieser Test und kein anderer. Mit Tesify formulierst du diesen Absatz aus deinen eigenen Prüfergebnissen — belegbar, sauber strukturiert und zu 100 % von dir geschrieben.
Was du nicht tun darfst
- Beide Tests rechnen und den günstigeren berichten. Das ist selektive Berichterstattung und methodisch nicht haltbar. Lege die Entscheidungsregel vor der Auswertung fest.
- Als Robustheitsprüfung ist das Gegenteil richtig: beide rechnen, beide berichten und feststellen, dass sie zum selben Schluss führen. Der Unterschied liegt darin, dass du vorher ankündigst, es so zu tun.
- Den t-Test auf ein Einzelitem einer fünfstufigen Skala anwenden und die Diskussion darüber im Text vermeiden. Wenn du es aus fachlicher Konvention trotzdem tust, benenne es und ergänze den Rangtest.
- Die Voraussetzungsprüfung erwähnen, aber nicht zeigen. «Die Voraussetzungen wurden geprüft» ohne Angabe des Verfahrens und des Befunds zählt nicht.
- Aus einem nicht signifikanten Ergebnis Gleichheit folgern. Kein Unterschied nachweisbar ist nicht dasselbe wie kein Unterschied vorhanden — dafür bräuchtest du ein Äquivalenztestverfahren.
Häufige Fragen
Vergleicht der Mann-Whitney-U-Test die Mediane?
Nur unter einer Zusatzbedingung. Streng genommen prüft er, ob ein zufällig gezogener Wert aus einer Gruppe mit höherer Wahrscheinlichkeit grösser ist als einer aus der anderen. Als Medianvergleich lässt sich das lesen, wenn beide Verteilungen dieselbe Form und Streuung haben. Ist das nicht der Fall, formuliere über zentrale Tendenz oder Ränge.
Darf ich den t-Test bei Likert-Daten verwenden?
Bei einem gemittelten Skalenwert aus mehreren Items ist es in vielen Fächern übliche Praxis und in der Regel unproblematisch. Bei einem einzelnen Item mit fünf Stufen ist der Rangtest die saubere Wahl. Entscheidend ist, dass du deine Entscheidung im Methodenteil begründest und nicht stillschweigend triffst.
Was mache ich bei ungleich grossen Gruppen?
Ungleiche Gruppengrössen sind für beide Tests zulässig, machen sie aber empfindlicher gegenüber ungleichen Varianzen. Prüfe deshalb den Levene-Test besonders sorgfältig und nimm im Zweifel den Welch-Test. Bei sehr kleinen Gruppen unter 15 Fällen ist zusätzlich der Rangtest sinnvoll.
Welchen Test nehme ich bei zwei Messzeitpunkten derselben Personen?
Keinen der beiden. Für abhängige Stichproben brauchst du den t-Test für abhängige Stichproben oder — als Rangalternative — den Wilcoxon-Vorzeichen-Rang-Test. Die Normalverteilungsannahme bezieht sich dabei auf die Differenzwerte, nicht auf die einzelnen Messungen.
Ist der Mann-Whitney-U-Test weniger wert als ein t-Test?
Nein. Bei normalverteilten Daten verliert er rund fünf Prozent Effizienz, bei schiefen Verteilungen ist er dem t-Test überlegen. Bewertet wird ohnehin nicht das Verfahren, sondern die Begründung: Ein passender Rangtest mit sauberer Herleitung ist deutlich besser als ein t-Test mit erkennbar verletzten Voraussetzungen.
Welche Effektstärke berichte ich zum Mann-Whitney-U-Test?
Üblich sind die rangbiseriale Korrelation oder r = |Z| / √N, jeweils mit den Richtwerten 0,10 (klein), 0,30 (mittel) und 0,50 (gross). Cohens d passt hier nicht, weil es auf Mittelwerten und Standardabweichungen beruht. Ergänze Median und Interquartilsabstand je Gruppe.