Die multiple Regression ist das Verfahren, mit dem in Abschlussarbeiten am häufigsten gerechnet und am zweithäufigsten falsch berichtet wird. Der Menüweg in SPSS ist in dreissig Sekunden geklickt — die Arbeit steckt davor (welche Variablen, wie kodiert) und danach (welche der vier Ausgabetabellen sagt was). Dieser Beitrag geht beides durch, in der Reihenfolge, in der du es brauchst.
Wann eine multiple Regression passt
Die multiple lineare Regression beantwortet eine Frage der Form: Wie gut lässt sich eine metrische abhängige Variable durch mehrere unabhängige Variablen gemeinsam vorhersagen — und welchen eigenständigen Beitrag leistet jede einzelne davon, wenn die anderen konstant gehalten werden? Genau dieser Zusatz «unter Kontrolle der übrigen Prädiktoren» ist der Grund, warum eine Regression mehr leistet als mehrere einzelne Korrelationen.
Voraussetzung ist eine metrische abhängige Variable. Ist sie dichotom (bestanden/nicht bestanden), brauchst du eine binär-logistische Regression; ist sie eine Häufigkeit, eine Poisson-Regression. Die Prädiktoren dürfen dagegen gemischt sein: metrisch, dichotom oder — nach Umkodierung — kategorial.
Zur Fallzahl kursieren mehrere Faustregeln (10 oder 20 Fälle je Prädiktor). Verlässlicher ist eine Poweranalyse: Für vier Prädiktoren, einen mittleren Effekt (f² = 0,15), α = ,05 und eine Teststärke von ,80 werden 85 Fälle benötigt. Wie du das für dein eigenes Modell rechnest, steht im Beitrag zur Stichprobengrösse mit G*Power.
Vorbereitung: Skalenniveau und Dummy-Kodierung
Bevor du das Menü öffnest, müssen drei Dinge im Datensatz stimmen.
Erstens das Messniveau in der Variablenansicht. SPSS nutzt die Spalte «Messniveau» für Voreinstellungen und Warnungen. Setze metrische Variablen auf «Metrisch», Dummy-Variablen auf «Nominal».
Zweitens die Dummy-Kodierung kategorialer Prädiktoren. Eine Variable mit k Kategorien wird zu k−1 Dummy-Variablen mit den Werten 0 und 1; die weggelassene Kategorie ist die Referenz, gegen die alle Koeffizienten interpretiert werden. Bei vier Studiengängen entstehen also drei Dummy-Variablen, und du benennst im Text ausdrücklich, welcher Studiengang die Referenz ist. Der klassische Fehler ist, eine nominale Variable mit den Codes 1 bis 4 direkt als Prädiktor einzugeben — SPSS behandelt sie dann als metrisch und rechnet Unsinn.
Drittens die Richtung der Items. Negativ formulierte Items müssen umgepolt sein, bevor Skalenwerte gebildet werden. Was Konstrukt, Indikator und Skalenniveau in deinem Modell genau bedeuten, klärt der Beitrag zur Operationalisierung der Variablen.
Der Menüweg in SPSS, Klick für Klick
- Analysieren → Regression → Linear.
- Die abhängige Variable in das Feld Abhängige Variable ziehen.
- Alle Prädiktoren in das Feld Unabhängige Variablen. Die Methode bleibt auf Einschluss — schrittweise Verfahren («Schrittweise», «Vorwärts», «Rückwärts») wählen Prädiktoren datengesteuert aus und sind in hypothesengeleiteten Arbeiten nicht angebracht.
- Statistiken: Schätzer, Konfidenzintervalle (95 %), Anpassungsgüte des Modells, Deskriptive Statistiken, Kollinearitätsdiagnose und unter «Residuen» Durbin-Watson sowie Fallweise Diagnose bei Ausreissern über 3 Standardabweichungen.
- Diagramme:
*ZRESIDauf die Y-Achse,*ZPREDauf die X-Achse; zusätzlich Histogramm und Normalverteilungsdiagramm der standardisierten Residuen ankreuzen. - Speichern: unter «Distanzen» Cook-Distanz und Hebelwerte, unter «Residuen» die standardisierten Residuen. SPSS legt sie als neue Variablen im Datensatz ab.
- Mit OK bestätigen.
Wer den Ablauf lieber als Syntax dokumentiert — was für die Nachvollziehbarkeit deutlich besser ist —, klickt statt auf OK auf Einfügen. SPSS schreibt die vollständige Syntax in ein Syntaxfenster, das du speichern und in den Anhang legen kannst.
Fünf Voraussetzungen und wo sie im Output stehen
| Voraussetzung | Wo im Output | Was unauffällig ist | Wenn verletzt |
|---|---|---|---|
| Linearer Zusammenhang | Streudiagramme je Prädiktor, Residuendiagramm | keine erkennbare Krümmung | quadratischen Term aufnehmen oder Variable transformieren |
| Unabhängigkeit der Residuen | Durbin-Watson in der Modellzusammenfassung | etwa 1,5 bis 2,5 | Datenstruktur prüfen (Messwiederholung, Klassen, Zeitreihe) |
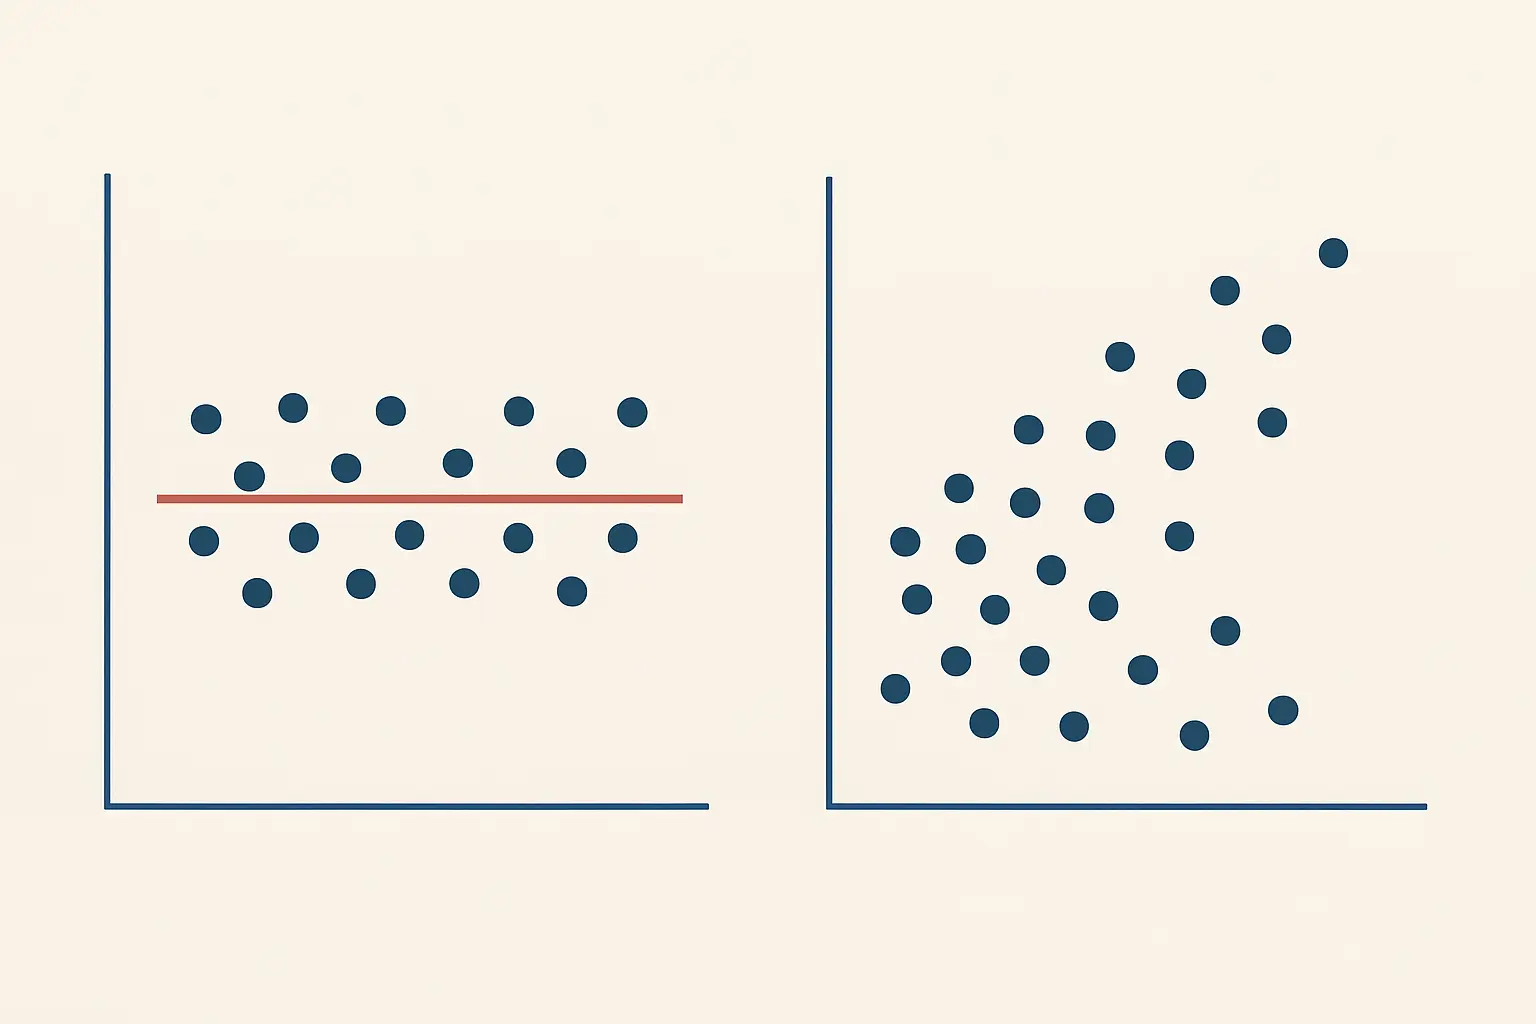
| Homoskedastizität | Diagramm *ZRESID gegen *ZPRED | gleichmässiges Band ohne Trichterform | robuste Standardfehler oder Transformation der abhängigen Variable |
| Normalverteilte Residuen | Histogramm und P-P-Diagramm der Residuen | Punkte nahe der Diagonalen | bei grossem n meist unkritisch; sonst Bootstrapping |
| Keine Multikollinearität | Kollinearitätsstatistik in der Koeffiziententabelle | VIF unter 5, Toleranz über 0,20 | Prädiktor entfernen oder zu einem Index zusammenfassen |
Zwei Präzisierungen, die häufig fehlen. Die Normalverteilungsannahme gilt hier ausschliesslich für die Residuen, nie für die Prädiktoren — eine Dummy-Variable ist nie normalverteilt und muss es auch nicht sein. Die Details dazu stehen im Beitrag zum Prüfen der Normalverteilung. Und beim VIF kursieren zwei Grenzwerte: 10 ist die klassische, sehr grosszügige Marke, 5 die heute üblichere. Nenne den Grenzwert, den du verwendest, ausdrücklich im Text.
Für Ausreisser bietet die gespeicherte Cook-Distanz eine einfache Regel: Werte über 1 gelten als einflussreiche Fälle, die du dir einzeln ansiehst. Löschen darfst du sie nur mit inhaltlicher Begründung — und die Entscheidung samt Zahl der ausgeschlossenen Fälle gehört in den Methodenteil, nicht in eine stille Korrektur des Datensatzes.
Die vier Ausgabetabellen lesen
Modellzusammenfassung
Hier stehen R (die multiple Korrelation), R² (der Anteil erklärter Varianz), das korrigierte R² und der Standardfehler der Schätzung. Berichte das korrigierte R²: Es bestraft zusätzliche Prädiktoren und ist die ehrlichere Zahl, weil das unkorrigierte R² mit jedem weiteren Prädiktor mechanisch steigt. In dieser Tabelle steht auch der Durbin-Watson-Wert.
ANOVA
Diese Tabelle prüft, ob das Modell insgesamt mehr erklärt als der blosse Mittelwert. Aus ihr entnimmst du F, die beiden Freiheitsgrade und p. Ein nicht signifikantes F bedeutet, dass sich die Interpretation einzelner Koeffizienten erübrigt.
Koeffizienten
Die inhaltlich wichtigste Tabelle. Für jeden Prädiktor findest du das unstandardisierte B mit Standardfehler, das standardisierte Beta, t, die Signifikanz und — wenn aktiviert — das 95-%-Konfidenzintervall für B sowie Toleranz und VIF. Die Konstante ist der vorhergesagte Wert, wenn alle Prädiktoren null sind; sie ist oft inhaltlich bedeutungslos und wird trotzdem mitberichtet.
Fallweise Diagnose und Residuenstatistik
Listet Fälle mit auffällig grossen standardisierten Residuen und fasst Minimum, Maximum, Mittelwert und Standardabweichung der Residuen zusammen. Kurz prüfen, nicht berichten.

B oder Beta — welchen Koeffizienten du berichtest
Beide, aber für unterschiedliche Aussagen.
- B (unstandardisiert) steht in der Einheit deiner Variablen: «Pro zusätzlichem Punkt auf der Belastungsskala sinkt die Zufriedenheit um 0,42 Skalenpunkte.» Das ist die inhaltlich aussagekräftige Zahl und gehört mit ihrem Konfidenzintervall in die Tabelle.
- Beta (standardisiert) ist einheitenlos und macht Prädiktoren innerhalb desselben Modells vergleichbar: Welcher hat den stärkeren Einfluss? Für Vergleiche über verschiedene Stichproben hinweg taugt Beta dagegen nicht, weil es von den Streuungen der jeweiligen Stichprobe abhängt.
Bei Dummy-Variablen ist B leicht zu interpretieren, Beta dagegen kaum — hier führst du die Aussage immer über B und die Referenzkategorie.
Hierarchische Regression in Blöcken
Wenn deine Hypothese lautet, dass ein Prädiktor über bekannte Kontrollvariablen hinaus etwas erklärt, ist die blockweise Eingabe der passende Weg. Im Dialog gibst du zuerst die Kontrollvariablen ein, klickst auf Weiter und trägst im zweiten Block deinen eigentlichen Prädiktor ein. Unter Statistiken aktivierst du zusätzlich Änderung in R-Quadrat.
Interessant ist dann nicht mehr das Gesamtmodell, sondern ΔR² und dessen F-Test: Wie viel zusätzliche Varianz erklärt Block 2 über Block 1 hinaus? Der Satz im Ergebnisteil lautet etwa: «Die Aufnahme der Selbstwirksamkeit in Block 2 erhöhte die erklärte Varianz signifikant um ΔR² = ,07, F(1, 118) = 9,84, p = ,002.»
Wichtig: Die Reihenfolge der Blöcke ist eine theoretische Entscheidung, die du vorab begründest — sie nachträglich zu ändern, bis ΔR² signifikant wird, ist selektive Auswertung.
Vom Output zum Ergebniskapitel. Die Tabellen stehen, aber der Text dazu will nicht entstehen? Mit Tesify formulierst du dein Ergebnis- und Methodenkapitel aus deinen eigenen Kennwerten und Notizen aus — strukturiert, belegbar und zu 100 % von dir geschrieben.
Tabelle und Satz für den Ergebnisteil
Eine Regressionstabelle enthält je Prädiktor mindestens B, den Standardfehler, das 95-%-Konfidenzintervall, β und p; darunter stehen R², korrigiertes R², F mit Freiheitsgraden und N. Der begleitende Text fasst zusammen, was die Tabelle nicht sagt:
«Das Modell erklärte einen signifikanten Anteil der Varianz der Studienzufriedenheit, korrigiertes R² = ,31, F(4, 118) = 14,72, p < ,001. Von den vier Prädiktoren leistete die wahrgenommene Betreuungsqualität den stärksten eigenständigen Beitrag, B = 0,42, 95-%-KI [0,24; 0,60], β = ,38, t = 4,61, p < ,001. Die Studiendauer hatte dagegen keinen signifikanten Effekt, B = −0,05, 95-%-KI [−0,17; 0,07], β = −,06, t = −0,82, p = ,414. Alle VIF-Werte lagen unter 2,1, sodass keine problematische Multikollinearität vorlag.»
Beachte das deutschsprachige Dezimalkomma und die Konvention, führende Nullen bei Kennwerten wegzulassen, die nicht grösser als eins werden können (p, β, R²). Den Aufbau des Kapitels insgesamt behandelt der Beitrag zum Ergebnisteil der Bachelorarbeit.
Häufige Fehler
- Schrittweise Methode verwenden. «Schrittweise» sucht sich datengesteuert die Prädiktoren, die in dieser Stichprobe am besten passen. Das produziert nicht replizierbare Modelle und widerspricht hypothesengeleitetem Vorgehen.
- Kausalität behaupten. Eine Regression auf Querschnittsdaten zeigt Zusammenhänge unter Kontrolle anderer Variablen — keine Wirkungen. Formuliere «hängt zusammen mit», «sagt vorher», nicht «verursacht».
- Nur R² berichten. Ohne F, Freiheitsgrade, Koeffizienten und N ist die Zahl nicht überprüfbar.
- Multikollinearität ignorieren. Zwei fast identische Skalen als getrennte Prädiktoren führen zu instabilen, teils vorzeichenverkehrten Koeffizienten — bei unauffälligem Gesamtmodell.
- Die Voraussetzungsprüfung weglassen. Sie kostet zwei Absätze und ist der Teil, den Gutachtende zuerst suchen.
Häufige Fragen
Wie viele Fälle brauche ich für eine multiple Regression?
Die verbreiteten Faustregeln lauten 10 bis 20 Fälle je Prädiktor. Belastbarer ist eine Poweranalyse: Für vier Prädiktoren, einen mittleren Effekt (f² = 0,15), α = ,05 und eine Teststärke von ,80 werden 85 Fälle benötigt. Mit acht Prädiktoren steigt die Zahl deutlich über hundert.
Ab welchem VIF-Wert liegt Multikollinearität vor?
Es gibt zwei gebräuchliche Grenzwerte: VIF über 10 gilt seit langem als kritisch, VIF über 5 ist die heute strengere und üblichere Marke. Gleichwertig lässt sich die Toleranz lesen, die unter 0,20 auffällig wird. Nenne den verwendeten Grenzwert im Text und begründe ihn nicht nachträglich.
Muss ich B oder Beta berichten?
Beide. B mit Konfidenzintervall ist die inhaltlich interpretierbare Grösse in der Einheit deiner Variablen, Beta macht die Prädiktoren innerhalb desselben Modells vergleichbar. Bei Dummy-Variablen führst du die Aussage immer über B und benennst die Referenzkategorie.
Darf ich eine kategoriale Variable als Prädiktor aufnehmen?
Ja, aber nur dummy-kodiert. Eine Variable mit k Kategorien wird zu k−1 Variablen mit den Werten 0 und 1; die ausgelassene Kategorie ist die Referenz. Eine nominale Variable mit den Codes 1 bis 4 direkt einzugeben, ist einer der häufigsten Fehler in Abschlussarbeiten.
Was mache ich, wenn das Residuendiagramm eine Trichterform zeigt?
Das ist Heteroskedastizität: Die Streuung der Residuen wächst mit den vorhergesagten Werten. Die Koeffizienten bleiben unverzerrt, aber die Standardfehler und damit p-Werte und Konfidenzintervalle stimmen nicht mehr. Abhilfe schaffen robuste Standardfehler oder eine Logarithmustransformation der abhängigen Variable.
Was ist der Unterschied zwischen R² und korrigiertem R²?
R² gibt den Anteil erklärter Varianz in der vorliegenden Stichprobe an und steigt mit jedem zusätzlichen Prädiktor, auch wenn dieser nichts beiträgt. Das korrigierte R² bestraft zusätzliche Prädiktoren und schätzt den Wert in der Grundgesamtheit. In Abschlussarbeiten wird das korrigierte R² berichtet, oft zusammen mit dem unkorrigierten.