
Der Test ist signifikant, das Häkchen in der Hypothesentabelle sitzt — und dann steht im Betreuungsgespräch die Frage: «Und wie gross ist der Effekt?» Genau dafür gibt es Effektstärken. Sie beantworten die Frage, die ein p-Wert prinzipiell nicht beantworten kann, und Cohens d ist das Mass, das dir in einer Abschlussarbeit am häufigsten begegnet.
Was eine Effektstärke misst
Ein Signifikanztest beantwortet eine einzige Frage: Wie verträglich sind meine Daten mit der Annahme, dass es überhaupt keinen Unterschied gibt? Er sagt nichts darüber, ob der gefundene Unterschied gross genug ist, um jemanden zu interessieren. Und weil der p-Wert direkt von der Fallzahl abhängt, wird bei ausreichend vielen Fällen praktisch jeder noch so winzige Unterschied signifikant.
Die Effektstärke entkoppelt genau das. Sie ist ein standardisiertes Mass für die Grösse eines Zusammenhangs oder Unterschieds und hängt — anders als der p-Wert — nicht systematisch von n ab. Zwei Studien mit 40 und mit 4000 Befragten können denselben Wert d = 0,35 liefern; nur die Präzision dieser Schätzung unterscheidet sich, und die liest du am Konfidenzintervall ab.
Damit erfüllt die Effektstärke drei Aufgaben in deiner Arbeit:
- Interpretation. Sie übersetzt eine Teststatistik in eine Aussage über Ausmass.
- Vergleichbarkeit. Weil sie einheitenfrei ist, lassen sich Ergebnisse verschiedener Studien und verschiedener Instrumente nebeneinanderstellen — die Grundlage jeder Metaanalyse.
- Planung. Jede A-priori-Poweranalyse braucht als Eingabe eine erwartete Effektstärke. Wie du daraus die nötige Fallzahl gewinnst, steht im Beitrag zur Stichprobengrösse mit G*Power.
Cohens d: Formel und Varianten
Die Grundidee ist eine Division: Du teilst die Differenz der beiden Mittelwerte durch ein Streuungsmass. Das Ergebnis liest sich als «so viele Standardabweichungen liegen die Gruppen auseinander».
d = (M₁ − M₂) / SD
Der Streit steckt im Nenner, und genau dort entstehen die Varianten, die in Programmausgaben unterschiedlich heissen:
| Variante | Nenner | Wann du sie nimmst |
|---|---|---|
| Cohens d | gepoolte Standardabweichung beider Gruppen | Standardfall bei zwei unabhängigen Gruppen |
| Hedges‘ g | gepoolte SD mit Korrekturfaktor | bei kleinen Stichproben, etwa unter 20 pro Gruppe |
| Glass‘ delta | nur die SD der Kontrollgruppe | wenn die Intervention die Streuung selbst verändert hat |
| dz | SD der Differenzwerte | abhängige Stichproben, also Messwiederholung |
Zwei Hinweise, die in Abschlussarbeiten regelmässig danebengehen. Erstens: Hedges‘ g ist bei kleinem n systematisch etwas kleiner als d und die ehrlichere Angabe — der unkorrigierte Wert überschätzt den Effekt. Bei über 50 Fällen pro Gruppe ist der Unterschied vernachlässigbar. Zweitens: dz aus einem t-Test für abhängige Stichproben ist nicht mit einem d aus einem Gruppenvergleich vergleichbar, weil im Nenner eine andere Streuung steht. Wer beide in derselben Tabelle nebeneinanderstellt, vergleicht Unvergleichbares — schreibe deshalb dazu, welche Variante gemeint ist.
Ein Rechenbeispiel: Die Interventionsgruppe erreicht M = 4,10 bei SD = 0,80, die Kontrollgruppe M = 3,70 bei SD = 0,90, beide mit je 50 Fällen. Die gepoolte Standardabweichung liegt bei rund 0,85, die Differenz bei 0,40 — also d = 0,40 / 0,85 = 0,47. Ein knapp mittlerer Effekt. Hätte dieselbe Differenz bei einer gepoolten Streuung von nur 0,40 vorgelegen, wäre d = 1,00 herausgekommen: identische Rohdifferenz, doppelt so starkes Ergebnis, weil die Gruppen in sich homogener sind.
Warum 0,20 / 0,50 / 0,80 kein Naturgesetz ist
Jacob Cohen hat diese Richtwerte in den 1960er-Jahren als Notbehelf vorgeschlagen — ausdrücklich für Situationen, in denen es im Fachgebiet noch keine Vergleichswerte gibt. Er selbst hat vor der mechanischen Anwendung gewarnt. Heute sind sie das am häufigsten zitierte Etikett der Sozialwissenschaften und werden meist so gebraucht, wie er es nicht wollte.
Das Problem ist inhaltlich, nicht formal. Was «klein» heisst, hängt vom Feld ab:
- In der Bildungsforschung gilt eine Unterrichtsmassnahme mit d = 0,40 als beachtlich, weil sie mit vertretbarem Aufwand einen realen Lernzuwachs erzeugt.
- In der Persönlichkeitspsychologie sind Zusammenhänge um r = 0,20 typisch, und ein Wert von 0,50 wäre ungewöhnlich hoch.
- In der Medizin kann ein d von 0,10 lebensrettend sein, wenn die Massnahme billig ist und Millionen betrifft.
- Bei Manipulationschecks erwartet man dagegen sehr grosse Werte — ein d von 0,30 würde dort bedeuten, dass die Manipulation kaum gewirkt hat.
Die gute Formulierung in deiner Arbeit nennt deshalb beides: die Konvention und den Feldbezug. «Der Effekt ist nach den gängigen Konventionen mittelgross (d = 0,52) und liegt damit im Bereich dessen, was Metaanalysen zu vergleichbaren Interventionen berichten (d zwischen 0,30 und 0,60).» Dieser zweite Halbsatz ist es, der eine Interpretation aus einer Etikettierung macht — und er kostet dich eine einzige Literaturstelle.
Die anderen Effektstärkemasse
Cohens d passt zu Mittelwertvergleichen. Für andere Verfahren brauchst du andere Masse, und die Richtwerte unterscheiden sich:
| Verfahren | Mass | klein | mittel | gross |
|---|---|---|---|---|
| t-Test | d bzw. g | 0,20 | 0,50 | 0,80 |
| Korrelation | r | 0,10 | 0,30 | 0,50 |
| ANOVA | partielles η² | 0,01 | 0,06 | 0,14 |
| Regression | f² | 0,02 | 0,15 | 0,35 |
| Chi-Quadrat (2×2) | Phi bzw. Cramérs V | 0,10 | 0,30 | 0,50 |
| Mann-Whitney-U | r = Z / √N | 0,10 | 0,30 | 0,50 |
Die letzte Zeile ist praktisch wichtig: Auch für rangbasierte Verfahren gibt es eine Effektstärke, und viele Arbeiten lassen sie einfach weg. Wenn du dich für ein nichtparametrisches Verfahren entschieden hast — die Entscheidungslogik dazu steht im Beitrag t-Test oder Mann-Whitney-U-Test —, dann berichtest du r aus dem Z-Wert deiner Ausgabe geteilt durch die Wurzel aus der Gesamtfallzahl.
Beim partiellen η² lauert eine Verwechslungsfalle: SPSS gibt in der ANOVA-Tabelle standardmässig das partielle Eta-Quadrat aus, viele Lehrbücher nennen die Richtwerte aber für das gewöhnliche Eta-Quadrat. Bei mehreren Faktoren fallen die beiden auseinander, weil das partielle Mass die übrigen Faktoren aus dem Nenner herausrechnet. Schreibe also in die Tabellenlegende, welches der beiden du berichtest.
Wo du d im Programm findest
- SPSS: Seit Version 27 liefert die Prozedur für den t-Test bei unabhängigen Stichproben auf Wunsch eine eigene Tabelle «Effektgrössen» mit Cohens d, Hedges‘ Korrektur und Glass‘ delta samt Konfidenzintervall. Das Kästchen dafür sitzt im Dialogfenster und ist standardmässig nicht gesetzt. Der übrige Weg durch die Auswertung steht im Beitrag zur SPSS-Auswertung.
- jamovi und JASP: In beiden Programmen ist «Effect size» eine Ankreuzoption direkt im t-Test-Dialog, das zugehörige Konfidenzintervall gleich daneben. Standardmässig wird Cohens d ausgegeben, Hedges‘ g lässt sich umschalten.
- R: Die Pakete
effectsizeundrstatixliefern d, g und die Intervalle in einem Aufruf. - Von Hand: Wenn du nur eine publizierte Tabelle mit Mittelwerten, Standardabweichungen und Gruppengrössen hast, reicht die Formel oben. Die gepoolte Standardabweichung ist das gewichtete quadratische Mittel der beiden Einzelstreuungen.
Von der Kennzahl zum Absatz. Die Effektstärke steht in der Ausgabe — die drei Sätze, die sie für deine Fragestellung einordnen, schreibst du selbst. Mit Tesify entwickelst du Ergebnis- und Diskussionsteil aus deinen eigenen Kennwerten — strukturiert, belegbar und zu 100 % von dir verfasst.
Berichten und interpretieren
Die Effektstärke gehört in denselben Satz wie die Teststatistik, nicht in eine separate Fussnote. Übliche Formen:
«Die Interventionsgruppe erzielte signifikant höhere Werte als die Kontrollgruppe, t(98) = 2,74, p = ,007, d = 0,55, 95-%-KI [0,15; 0,95].»
«Der Zusammenhang zwischen Betreuungsqualität und Studienzufriedenheit war mittelstark, r = ,34, p < ,001.»
Drei Konventionen dazu: Effektstärkemasse werden kursiv gesetzt, im deutschsprachigen Text mit Dezimalkomma geschrieben, und Werte, die nicht grösser als eins werden können — r, η², Phi —, verlieren die führende Null. Cohens d kann grösser als eins werden und behält sie deshalb.
Berichte das Konfidenzintervall der Effektstärke, wo dein Programm es anbietet. Ein d von 0,55 mit dem Intervall [0,15; 0,95] ist ein deutlich schwächerer Befund als dasselbe d mit [0,45; 0,65]. Und berichte Effektstärken auch dann, wenn das Ergebnis nicht signifikant geworden ist — dort ist die Angabe sogar besonders informativ, weil sie zeigt, ob der Effekt klein oder die Studie nur unterpowert war. Wie sich das in den Aufbau des Ergebnisteils einfügt, behandelt der Beitrag zur quantitativen Forschung.
Fünf typische Fehler
- Die Effektstärke ganz weglassen. Der häufigste Mangel und einer der wenigen, die praktisch immer im Gutachten auftauchen — weil er sich in dreissig Sekunden pro Test beheben liesse.
- Nur das Etikett nennen. «Es zeigte sich ein mittlerer Effekt» ohne Zahl ist keine Angabe. Immer den Wert schreiben.
- Die Konvention für den Befund halten. «Der Effekt ist mittelgross» beschreibt eine Tabellenzeile aus dem Jahr 1969, nicht deine Stichprobe.
- Varianten vermischen. d aus abhängigen und unabhängigen Stichproben in einer Tabelle, ohne den Unterschied zu kennzeichnen.
- Vom Effekt auf Kausalität schliessen. Ein grosses d in einem Querschnittsdesign bleibt ein Zusammenhang. Die Effektstärke misst Ausmass, nicht Ursache.
Häufige Fragen
Was bedeutet ein Cohens d von 0,5 konkret?
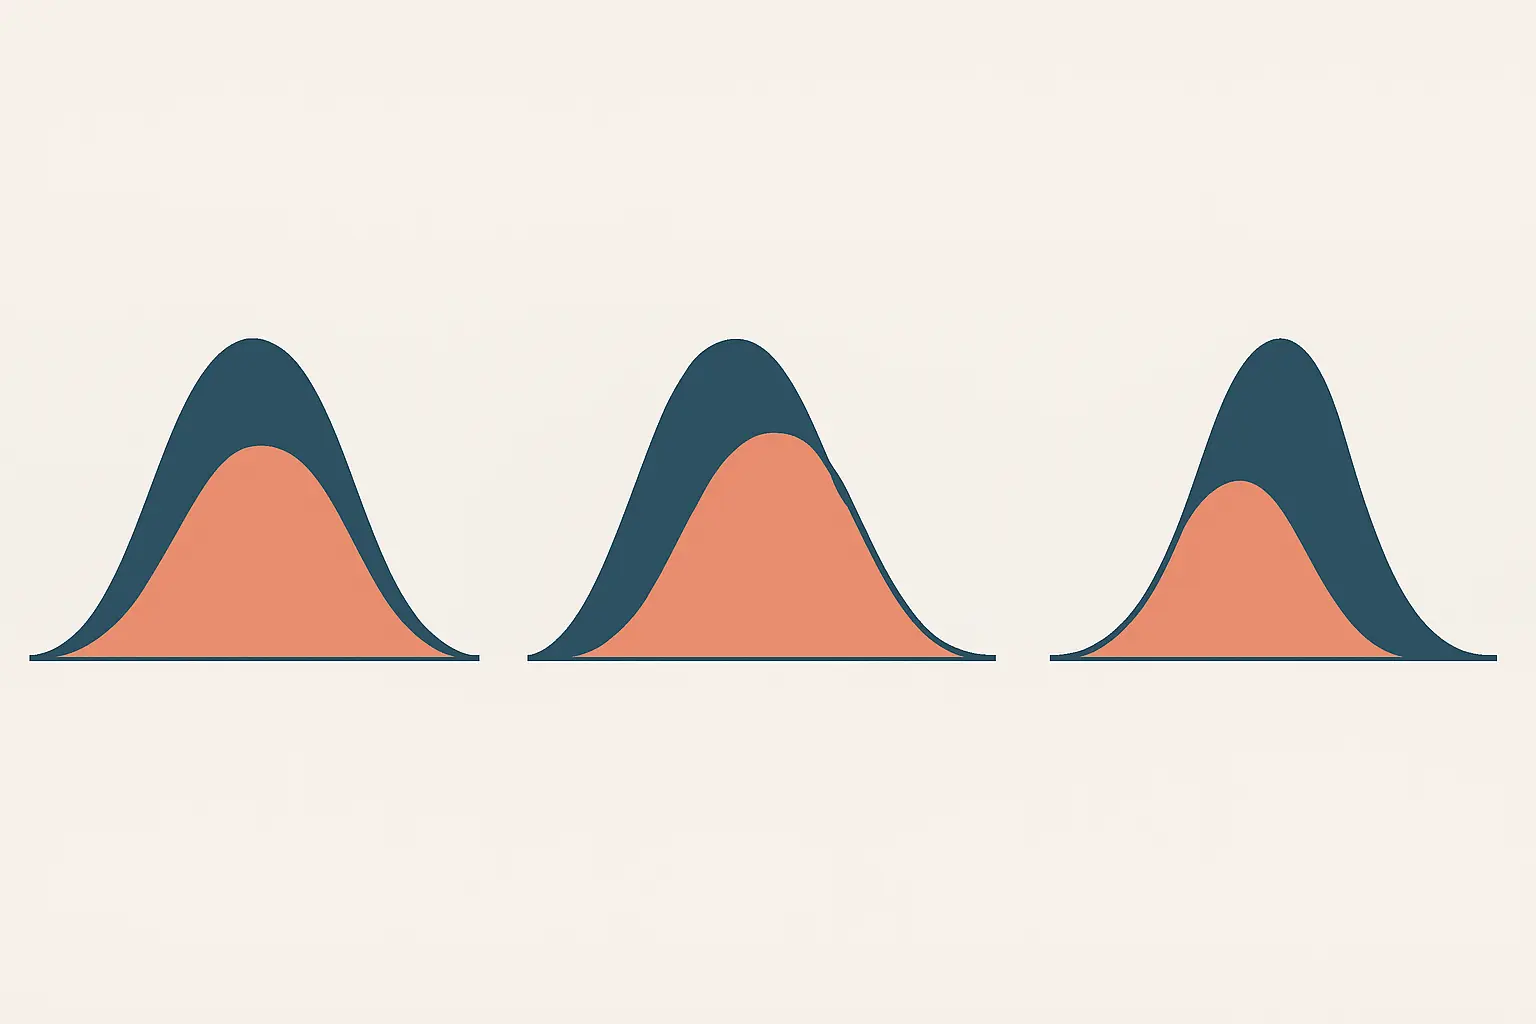
Die beiden Gruppenmittelwerte liegen eine halbe Standardabweichung auseinander. Anschaulich heisst das: Eine zufällig gezogene Person aus der stärkeren Gruppe hat in rund 64 Prozent der Fälle einen höheren Wert als eine zufällig gezogene Person aus der anderen Gruppe, und die beiden Verteilungen überlappen sich noch zu etwa 80 Prozent. Der Unterschied ist also deutlich sichtbar, aber weit davon entfernt, die Gruppen zu trennen.
Muss ich eine Effektstärke angeben, wenn mein Ergebnis nicht signifikant ist?
Ja, und dort ist sie besonders aufschlussreich. Ein nicht signifikantes Ergebnis mit d = 0,04 spricht dafür, dass es tatsächlich kaum einen Unterschied gibt. Dasselbe nicht signifikante Ergebnis mit d = 0,45 spricht dagegen dafür, dass deine Stichprobe zu klein war, um einen durchaus relevanten Effekt nachzuweisen. Diese Unterscheidung gehört in die Diskussion und in die Limitationen.
Was ist der Unterschied zwischen Cohens d und Hedges‘ g?
Beide messen dasselbe, aber Hedges‘ g korrigiert eine systematische Überschätzung, die bei kleinen Stichproben auftritt. Der korrigierte Wert ist deshalb immer etwas kleiner. Bei sehr kleinen Gruppen — unter etwa 20 Personen je Gruppe — ist g die angemessenere Angabe; ab rund 50 Fällen pro Gruppe unterscheiden sich die beiden Werte nur noch in der zweiten Nachkommastelle.
Kann Cohens d negativ oder grösser als 1 werden?
Beides ist möglich. Das Vorzeichen sagt nur, welche Gruppe im Zähler steht, und wird für die Beurteilung der Grösse ignoriert; achte aber darauf, die Richtung im Text korrekt zu benennen. Werte über 1 kommen vor, wenn die Gruppen sehr homogen sind oder die Intervention stark wirkt — in Manipulationschecks und Laborexperimenten ist das nichts Ungewöhnliches.
Welche Effektstärke gebe ich bei einer ANOVA an?
Üblich ist das partielle Eta-Quadrat, das SPSS auf Wunsch direkt in der Tabelle der Zwischensubjekteffekte ausgibt. Die Richtwerte lauten hier 0,01 klein, 0,06 mittel und 0,14 gross. Bei mehreren Faktoren solltest du in der Tabellenlegende ausdrücklich vermerken, dass es sich um das partielle und nicht um das gewöhnliche Eta-Quadrat handelt — die beiden Masse fallen dann auseinander.
Woher nehme ich die erwartete Effektstärke für die Fallzahlplanung?
In dieser Reihenfolge: aus einer Metaanalyse zu deinem Thema, aus einer methodisch vergleichbaren Einzelstudie, aus einer eigenen Pilotierung — und erst wenn nichts davon existiert, aus der Cohen-Konvention. Im letzten Fall begründest du die Wahl im Methodenteil und nennst sie in den Limitationen als Annahme. Eine zu optimistisch angesetzte Effektstärke ist der häufigste Grund für eine unterpowerte Abschlussarbeit.